凯蒂莱德基样本对比方法,数据分组细节决定结论
凯蒂莱德基样本对比方法之所以值得关注,是因为同一批比赛数据换一种分组,结论就会明显改变;数据分组细节决定结论,这不是统计技术的小事,而会影响对运动员能力、赛事价值和训练方向的判断。在游泳数据越来越细的今天,分组口径一旦含糊,优势大小和趋势判断都可能被带偏。
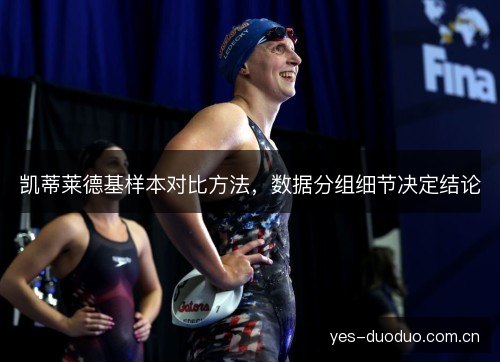
分析者把凯蒂莱德基的奥运会、世锦赛、美国全国锦标赛和NCAA锦标赛成绩整理成样本库,再按项目距离、泳姿、比赛阶段和泳池长度拆分。样本库看起来只是数据归档,真正的分歧从分组开始:同一场决赛被放进不同组,均值与排名就会改写。凯蒂莱德基的名字反复出现,口径却必须先讲清。
常见分组会按赛事级别、比赛年代、预赛与决赛、长池与短池、个人项目与接力分段设置。凯蒂莱德基在奥运会决赛的样本与她在国内选拔赛的样本并不承担同一种任务,混在一起算平均,等于把不同的比赛目标压成同一个数字。分组细节在这里不是脚注,而是结论的一部分。
只取奥运会决赛,凯蒂莱德基在四百米、八百米和一千五百米自由泳的领先幅度显得极大;一旦混入预赛、接力分段和美国全国锦标赛,差距就会缩小。预赛保留体力,接力有出发和交接条件,国内赛的对手强度也不同。样本分组一变,关于凯蒂莱德基优势的结论就从绝对统治变成相对领先。
按年代分组同样改变叙事。凯蒂莱德基从伦敦奥运会到里约奥运会再到东京奥运会,面对的对手从费代丽卡·佩莱格里尼、丽贝卡·阿德灵顿转向阿里亚妮·蒂特姆斯。若把不同年代样本合并,对手进步会被平均掉;若按奥运周期拆分,凯蒂莱德基的领先变化才看得清。分组细节决定结论,在这里体现得最直接。
这种差异来自样本选择偏差。多多28游戏凯蒂莱德基的奥运会决赛样本往往处在巅峰状态,国内赛样本可能夹在训练周期里,接力分段又要服从团队安排。把不同目标的样本放进同一组,研究者会误把训练课和决赛混为一谈。凯蒂莱德基样本对比方法若不标注分组口径,读者很难判断差距是能力差还是场景差。
对手样本也要匹配。拿凯蒂莱德基的决赛成绩去比阿里亚妮·蒂特姆斯的预赛成绩,会夸大凯蒂莱德基的优势;拿她的国内赛去比世锦赛决赛,又会低估她。合理做法是把双方放在同一赛事阶段、同一泳池长度和同一项目类型里。凯蒂莱德基样本对比方法的核心不是多收数据,而是让比较对象处在可解释的同一组。
在统计层面,分组会影响均值、方差和异常值判断。凯蒂莱德基的一千五百米自由泳样本数量少且成绩极端,单独分组时她的优势清晰,合并进短距离和接力样本后,极端值会被稀释。数据分组细节决定结论,也决定图表看起来是平稳还是跳跃。研究者若不报告分组规则,复现结果就会困难。
训练端会直接感受到这种差别。格雷格·米汉在斯坦福大学游泳队看凯蒂莱德基的数据,若只取奥运会决赛,会强化她的耐力优势;布鲁斯·格梅尔若把国内赛和接力分段纳入,则可能更早发现出发、转身和节奏分配的问题。凯蒂莱德基样本对比方法因此不是赛后谈资,而是训练计划的分组依据。
赛事叙事也会被分组改写。媒体比较凯蒂莱德基与阿里亚妮·蒂特姆斯时,若只选奥运会和世锦赛决赛,标题容易写成一边倒;若把预赛、接力以及不同年份的美国全国锦标赛放进去,标题就会变成优势收窄。凯蒂莱德基样本对比方法一旦离开分组说明,公众看到的差距可能只是编辑选择的结果。
选拔和团队安排同样依赖分组。美国游泳队在奥运选拔时若把凯蒂莱德基的国内赛与奥运会决赛混算,可能误判她的峰值状态;斯坦福大学游泳队在NCAA锦标赛前若只看长池数据,也会忽略短池转身的权重。凯蒂莱德基样本对比方法要服务于具体决策,就必须先说明样本来自哪类赛事、哪个阶段和哪种泳池。
后续的分析流程应当先定问题,再定分组,计算差距放在分组之后。想讨论凯蒂莱德基的奥运统治力,就限定奥运会决赛和长池个人项目;想讨论她的全面性,就把世锦赛、NCAA锦标赛和接力分段分层呈现。凯蒂莱德基样本对比方法只有把分组规则写在前头,结论才经得起换一批样本的检验。
数据分组细节决定结论,意味着讨论凯蒂莱德基时不能只抛出一个排名或差距。她要与阿里亚妮·蒂特姆斯、西蒙娜·曼努埃尔等对手比较,必须同时展示赛事、阶段、泳池和年代的分层。凯蒂莱德基样本对比方法的价值,正在于把伟大表现拆成可比较片段,又不抹掉每个片段的比赛语境。
往后的游泳数据讨论会更重视分组透明度。奥运会、世锦赛和NCAA锦标赛的样本各有目标,凯蒂莱德基的每一次决赛、预赛和接力分段都该带着口径进入比较。凯蒂莱德基样本对比方法若坚持把数据分组细节讲清,结论就不再是单一数字,而是一组可检验、可修正的判断。